
正则
正则表达式(英语:Regular Expression,常简写为regex、regexp或RE),又称正则表示式、正则表示法、规则表达式、常规表示法,是计算机科学的一个概念;
正则表达式使用单个字符串来描述、匹配一系列匹配某个句法规则的字符串。
许多程序设计语言都支持利用正则表达式进行字符串操作。
在JavaScript中,正则表达式使用RegExp类来创建,也有对应的字面量的方式:
- 正则表达式主要由两部分组成:模式(patterns)和修饰符(flags)
使用方法
简单使用:
// 创建正则

// 正则表达式由 匹配规则 和 匹配的修饰符flags 组成

// Regular Expression创建,i表示忽略大小写,g表示全局搜索
const re1 = new RegExp('abc', 'ig')
//字面量方式创建
const re2 = /abc/ig

// 使用正则
const message = 'gfdsabc23 f543sAbC gre455teAbc55 rte33abC'
// 不区分大小写将所有abc替换成'qwe'
const res1 = message.replaceAll(/abc/ig, 'qwe')
// 将所有数字移除 [0-9]或\d表示数字 +表示匹配一个或多个
const res2 = message.replaceAll(/[0-9]+/ig, '')
const res3 = message.replaceAll(/\d+/ig, '')

console.log(res1)
console.log(res2)
console.log(res3)
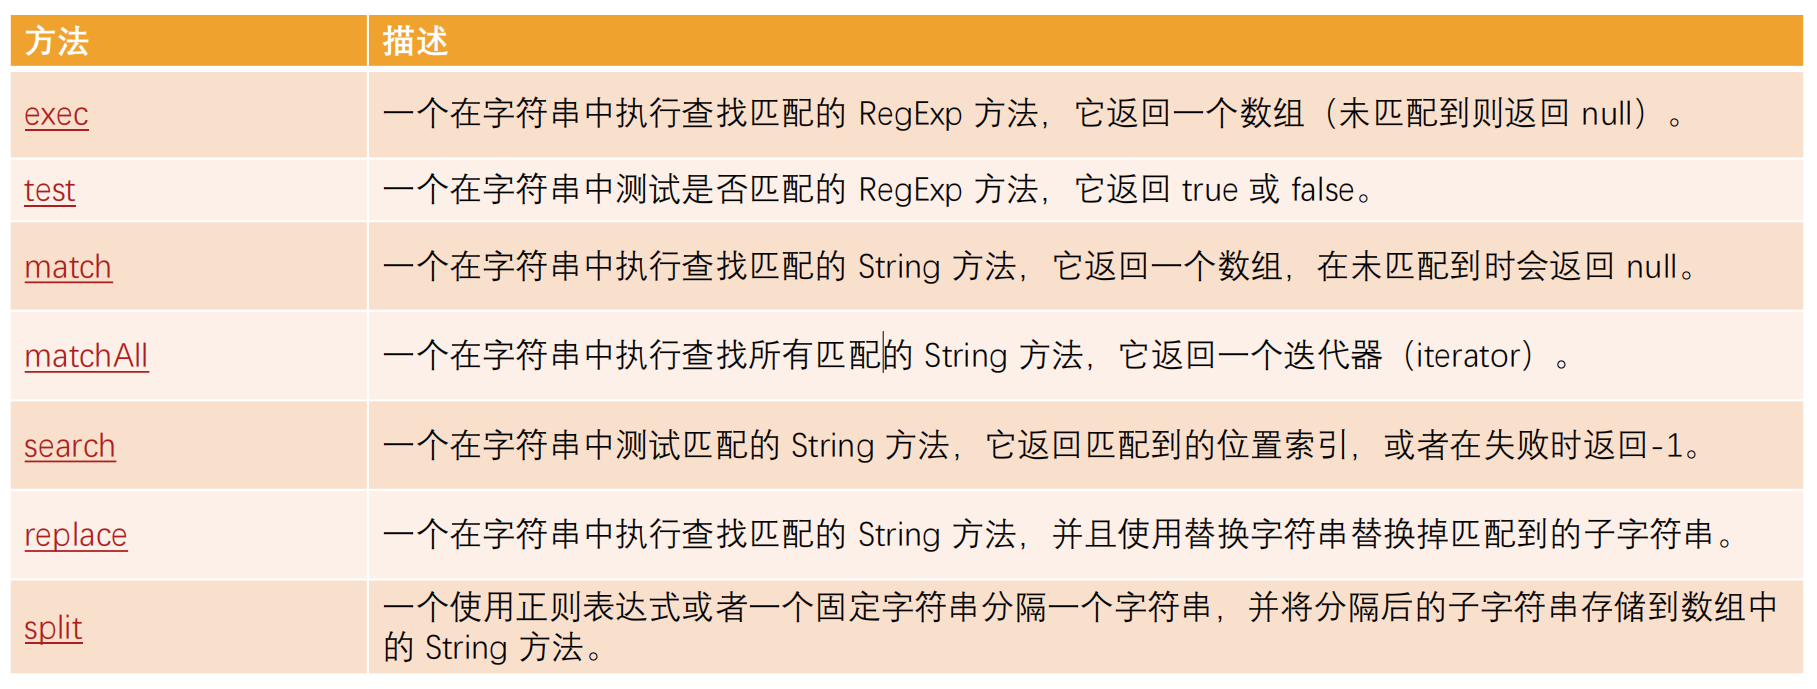
RegExp和String可使用正则的方法
- JavaScript中的正则表达式被用于 RegExp 的 exec 和 test 方法;
- 也包括 String 的 match、matchAll、replace、replaceAll、search 和 split 方法;
RegExp的test(常用)
<!DOCTYPE html>
<html lang="en">

<head>
</head>

<body>
  <input type="text" class="input">
  <span>请输入账号</span>
  <script>
    const el = document.getElementsByClassName('input')[0]
    const span = document.querySelector('span')

    // const reg = /aaaaa/
    const reg = /^qa{5,10}$/i  // ^表示开头 $表示结尾 a{5,10}表示a最少5个最多10个
    el.oninput = function () {
      const value = this.value
      console.log(value)
      // 1. RegExp的test方法
      if(reg.test(value)) {
        span.textContent = '输入符合规则'
      } else {
        span.textContent = '输入不符合规则,请重新输入'
      }
    }
  </script>
</body>

</html>
RegExp的exec
const re1 = /abc/ig
const message = 'gfdsabc23 f543sAbC gre455teAbc55 rte33abC'

console.log(re1.exec(message))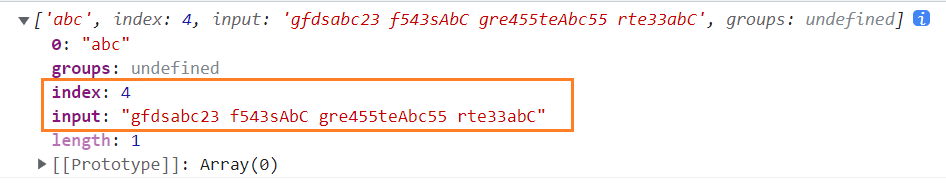
String的match方法(常用)
const re1 = /abc/ig
const message = 'gfdsabc23 f543sAbC gre455teAbc55 rte33abC'

console.log(message.match(re1)) // [ 'abc', 'AbC', 'Abc', 'abC' ]
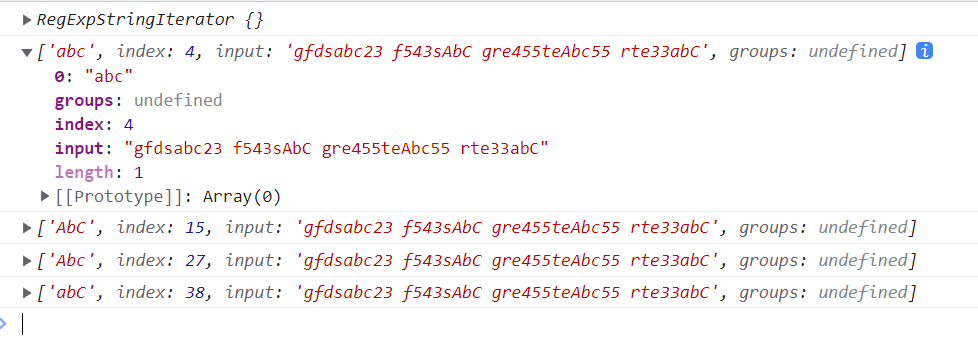
String的matchAll方法(了解)
matchAll使用的正则修饰符必须加上g,全局搜索,返回迭代器
const re1 = /abc/ig
const message = 'gfdsabc23 f543sAbC gre455teAbc55 rte33abC'

const res = message.matchAll(re1)
console.log(res)  // res.next() res.next()
for(let item of res) {
  console.log(item)
}
String的replace和replaceAll(常用)
String的split(常用)
const re1 = /abc/ig
const message = 'gfdsabc23 f543sAbC gre455teAbc55 rte33abC'

const res = message.split(re1)
console.log(res) // [ 'gfds', '23 f543s', ' gre455te', '55 rte33', '' ]
String的search(了解)
返回第一个匹配到的下标,未找到则返回-1
const re1 = /abc/ig
const message = 'gfdsabc23 f543sAbC gre455teAbc55 rte33abC'

const res = message.search(re1)
console.log(res) // 4
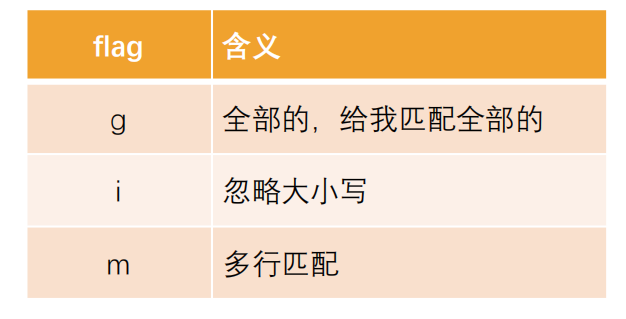
修饰符(大小写、全局、多行)
不使用g修饰父可以获取更详细的匹配结果!!结合()分组有奇效
匹配规则
字符类(\d,\s,\w,.)字符
字符类(Character classes) 是一个特殊的符号,匹配特定集中的任何符号。
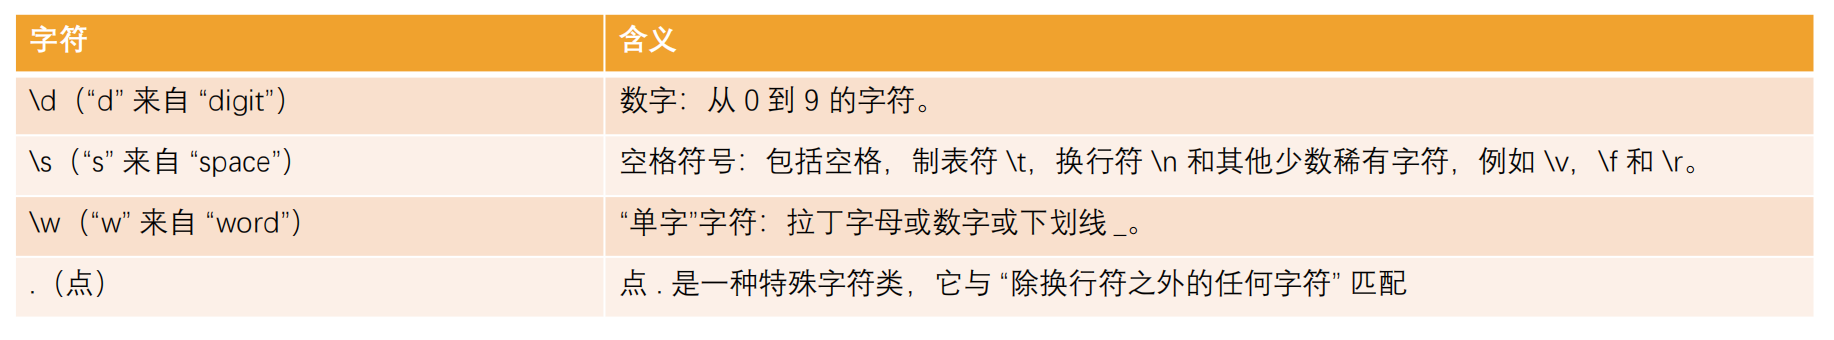
- \d相当于[0-9]
- \w相当于[a-zA-Z0-9_]
反向类
- \D 非数字:除 \d 以外的任何字符,例如字母。
- \S 非空格符号:除 \s 以外的任何字符,例如字母。
- \W 非单字字符:除 \w 以外的任何字符,例如非拉丁字母或空格。
锚点(^,$)起始
符号 ^ 和符号 $ 在正则表达式中具有特殊的意义,它们被称为“锚点”。
- 符号 ^ 匹配文本开头;
- 符号 $ 匹配文本末尾;
词边界(\b)
const re = /\bname\b/i // \w之外的字符即是边界,如: , !, ,,
const message = 'name is zzf'
const message1 = 'my name is zzf'
console.log(re.test(message)) // true
console.log(re.test(message1)) // true
const re1 = /\d\d:\d\d/ig
const re2 = /\b\d\d:\d\d\b/ig // 加上边界
const message2 = 'time is 12:34, 18:20, 123:456'
console.log(message2.match(re1)) // [ '12:34', '18:20', '23:45' ]
console.log(message2.match(re2)) // [ '12:34', '18:20' ]转义字符\
不进行转义的情况下
[a-zA-Z0-9]字符范围[abc]
*表示0个或多个字符
+表示一个或多个字符
^起始位置
$结束位置
?表示前面单字符为0个或一个
如果要把特殊字符作为常规字符来使用,需要对其进行转义:只需要在它前面加个反斜杠;
常见的需要转义的字符
[] \ ^ $ . | ? * + ( ) /
const arr = ['dsa.html', 'da.js', 'fsd.json', 'Home.jsx', 'format.js']

// 匹配所有以js、jsx结尾的文件
const re = /\.jsx?$/
const newArr = arr.filter(filename => re.test(filename))
console.log(newArr)
集合与范围[a-zA-Z0-9]
- 方括号也可以包含字符范围;
- 比如说,[a-z] 会匹配从 a 到 z 范围内的字母,[0-5] 表示从 0 到 5 的数字;
- [0-9A-F] 表示两个范围:它搜索一个字符,满足数字 0 到 9 或字母 A 到 F;
- \d —— 和 [0-9] 相同;
- \w —— 和 [a-zA-Z0-9_] 相同;
- 除了普通的范围匹配,还有类似 [ ^0-9]的“排除”范围匹配;\D
量词
- ,后面不能跟空格
- .:代表"一个"
- +:代表“一个或多个”,相当于 {1,}
- ?:代表“零个或一个”,相当于 {0,1}。换句话说,它使得符号变得可选;
- *:代表着“零个或多个”,相当于 {0,}。也就是说,这个字符可以多次出现或不出现;
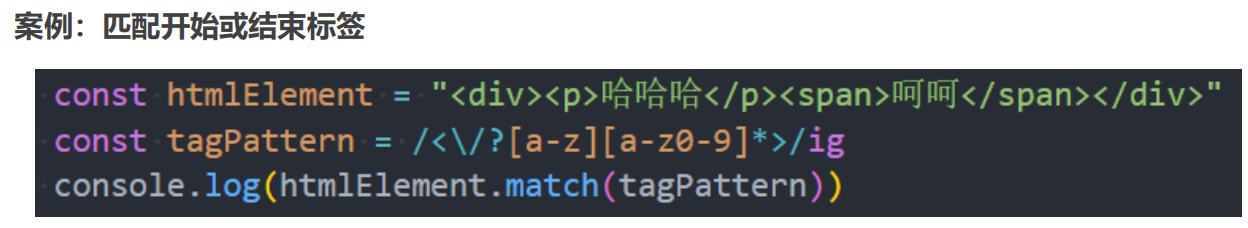
const message = '<div><span>哈哈</span><p>rqrq</p><i></i></div>'

// 匹配所有标签
const re = /<\/?[a-z][a-z0-9]*>/ig
console.log(message.match(re)) // ['<div>', '<span>', ...]
贪婪和惰性模式(量词后加?)
默认情况下的匹配规则是查找到匹配的内容后,会继续向后查找,一直找到最后一个匹配的内容
- 这种匹配的方式,我们称之为贪婪模式(Greedy)
懒惰模式中的量词与贪婪模式中的是相反的。
只要获取到对应的内容后,就不再继续向后匹配;
我们可以在量词后面再加一个问号 ‘?’ 来启用它;
所以匹配模式变为 *? 或 +?,甚至将 '?' 变为 ??;
const message = '书籍:《我与地坛》、《活着》、《文城》'

// 默认进行贪婪匹配
const re = /《.+》/ig
// 使用惰性匹配
const re1 = /《.+?》/ig
console.log(message.match(re)) // [ '《我与地坛》、《活着》、《文城》' ]
console.log(message.match(re1)) // [ '《我与地坛》', '《活着》', '《文城》' ]
捕获组
模式的一部分可以用括号括起来 (...),这称为“捕获组(capturing group)”。
在索引 0 处:完全匹配。
在索引 1 处:第一个括号的内容。
在索引 2 处:第二个括号的内容。
…等等
const message = '书籍:《我与地坛》、《活着》、《文城》'

// 使用惰性匹配
const re1 = /《(.+?)》/ig
const iterable = message.matchAll(re1) // 结合matchAll使用
for(let item of iterable) {
  console.log(item) // item为数组第0个表示全匹配结果,第一个表示第一个()的分组结果,第二个表示第二个()的分组结果
  console.log(item[1]) // '我与地坛' '活着' '文城'
}

// [
//   '《我与地坛》',
//   '我与地坛',
//   index: 3,
//   input: '书籍:《我与地坛》、《活着》、《文城》',
//   groups: undefined
// ]
// [
//   '《活着》',
//   '活着',
//   index: 10,
//   input: '书籍:《我与地坛》、《活着》、《文城》',
//   groups: undefined
// ]
// [
//   '《文城》',
//   '文城',
//   index: 15,
//   input: '书籍:《我与地坛》、《活着》、《文城》',
//   groups: undefined
// ]
捕获组补充
- 命名组:
- 用数字记录组很困难。
- 对于更复杂的模式,计算括号很不方便。我们有一个更好的选择:给括号起个名字。
- 这是通过在开始括号之后立即放置 ?
<name>来完成的。

非捕获组:
- 有时我们需要括号才能正确应用量词,但我们不希望它们的内容出现在结果中。
- 可以通过在开头添加 ?: 来排除组。

或|
or是正则表达式中的一个术语,实际上是一个简单的“或”。
在正则表达式中,它用竖线 | 表示;
通常会和捕获组一起来使用,在其中表示多个值;
const message = 'abcabcfeecbaafewcbacbasnbanbanbawf'

// 使用惰性匹配
const re1 = /(abc|cba|nba){2,}/ig
console.log(message.match(re1)) // [ 'abcabc', 'cbacba', 'nbanbanba' ]
常用正则表达式
字母+数字+特殊字符8-16位
/(?=.*[a-z_])(?=.*\d)(?=.*[^a-z0-9_])[\S]{8,16}/i手机号
/^(1[3|8|7|5][0-9]{9})$/身份证号(15位和18位) 方法错误
文心一言询问可获取更准确的身份证校验方法
/(^[1-9]\d{5}(18|19|([23]\d))\d{2}((0[1-9])|(10|11|12))(([0-2][1-9])|10|20|30|31)\d{3}[0-9Xx]$)|(^[1-9]\d{5}\d{2}((0[1-9])|(10|11|12))(([0-2][1-9])|10|20|30|31)\d{3}$)/