
1. 将一个“不定宽高的元素”设置水平垂直居中的方案有哪些
// 知道子元素宽高
// 1
.wp {
  position: relative;
}
.box {
  position: absolute;;
  top: calc(50% - 50px);
  left: calc(50% - 50px);
}
// 2
.wp {
  position: relative;
}
.box {
  position: absolute;;
  top: 50%;
  left: 50%;
  margin-left: -50px;
  margin-top: -50px;
}

// 不知道子元素宽高
// 1
.wp {
  display: flex;
  justify-content: center;
  align-items: center;
}
// 2
.wp {
  position: relative;
}
.box {
  position: absolute;
  top: 50%;
  left: 50%;
  transform: translate(-50%, -50%); // 重点
}
2. 两栏布局(左侧自适应,右侧定宽)怎么优先渲染右侧的内容
- 双浮动加calc属性
.outer4{overflow: hidden; border: 1px solid red;}
.sidebar4{float:left;width:200px;height:150px;background: #BCE8F1;}
.content4{float:left;width:calc(100% - 200px);height:100px;background: #F0AD4E;}- float+BFC方法
.outer6{overflow: auto; border: 1px solid red;}
.sidebar6{float: left;height:150px;background: #BCE8F1;}
.content6{overflow:auto;height:100px;background: #F0AD4E;}- flex方法
.outer7{display: flex; border: 1px solid red;}
.sidebar7{flex:0 0 200px;height:150px;background: #BCE8F1;}
.content7{flex: 1;height:100px;background: #F0AD4E;}
3. 跨域的解决方案有哪些?JSONP原理?CORS原理
jsonp解决跨域(jsonp只能实现get一种请求)
在浏览器中通过相应的标签从不同域名下加载静态资源,是被允许的
- 原生实现
<script>
var script = document.createElement('script');
script.type = 'text/javascript';

// 传参一个回调函数名给后端,方便后端返回时执行这个在前端定义的回调函数
script.src = 'http://www.domain2.com:8080/login?user=admin&callback=handleCallback';
document.head.appendChild(script);

// 回调执行函数
function handleCallback(res) {
    alert(JSON.stringify(res));
}
</script>- jquery ajax
$.ajax({
  url: 'http://www.domain2.com:8080/login',
  type: 'get',
  dataType: 'jsonp',  // 请求方式为jsonp
  jsonpCallback: "handleCallback",    // 自定义回调函数名
  data: {}
});- vue.js
this.$http.jsonp('http://www.domain2.com:8080/login', {
  params: {},
  jsonp: 'handleCallback'
}).then((res) => {
  console.log(res);
})
跨域资源共享(CORS)
普通跨域请求:只服务端设置Access-Control-Allow-Origin即可,前端无须设置,若要带cookie请求:前后端都需要设置。
需注意的是:由于同源策略的限制,所读取的cookie为跨域请求接口所在域的cookie,而非当前页。如果想实现当前页cookie的写入,可参考nginx反向代理中设置proxy_cookie_domain 和NodeJs中间件代理中cookieDomainRewrite参数的设置。
- 原生实现
var xhr = new XMLHttpRequest(); // IE8/9需用window.XDomainRequest兼容

// 前端设置是否带cookie
xhr.withCredentials = true;

xhr.open('post', 'http://www.domain2.com:8080/login', true);
xhr.setRequestHeader('Content-Type', 'application/x-www-form-urlencoded');
xhr.send('user=admin');

xhr.onreadystatechange = function() {
    if (xhr.readyState == 4 && xhr.status == 200) {
        alert(xhr.responseText);
    }
};- jquery + ajax
$.ajax({
    ...
   xhrFields: {
       withCredentials: true    // 前端设置是否带cookie
   },
   crossDomain: true,   // 会让请求头中包含跨域的额外信息,但不会含cookie
    ...
});- vue框架
- axios设置
axios.defaults.withCredentials = true- vue-resource设置
Vue.http.options.credentials = trueNode.js后台设置
var http = require('http');
var server = http.createServer();
var qs = require('querystring');

server.on('request', function(req, res) {
    var postData = '';

    // 数据块接收中
    req.addListener('data', function(chunk) {
        postData += chunk;
    });

    // 数据接收完毕
    req.addListener('end', function() {
        postData = qs.parse(postData);

        // 跨域后台设置
        res.writeHead(200, {
            'Access-Control-Allow-Credentials': 'true',     // 后端允许发送Cookie
            'Access-Control-Allow-Origin': 'http://www.domain1.com',    // 允许访问的域(协议+域名+端口)
            /*
             * 此处设置的cookie还是domain2的而非domain1,因为后端也不能跨域写cookie(nginx反向代理可以实现),
             * 但只要domain2中写入一次cookie认证,后面的跨域接口都能从domain2中获取cookie,从而实现所有的接口都能跨域访问
             */
            'Set-Cookie': 'l=a123456;Path=/;Domain=www.domain2.com;HttpOnly'  // HttpOnly的作用是让js无法读取cookie
        });

        res.write(JSON.stringify(postData));
        res.end();
    });
});

server.listen('8080');
console.log('Server is running at port 8080...');
nginx代理跨域
1. nginx配置解决iconfont跨域
浏览器跨域访问js、css、img等常规静态资源被同源策略许可,但iconfont字体文件**(eot|otf|ttf|woff|svg)例外**,此时可在nginx的静态资源服务器中加入以下配置。
location / {
  add_header Access-Control-Allow-Origin *;
}
2. nginx反向代理接口跨域
跨域原理: 同源策略是浏览器的安全策略,不是HTTP协议的一部分。服务器端调用HTTP接口只是使用HTTP协议,不会执行JS脚本,不需要同源策略,也就不存在跨越问题。
实现思路:通过nginx配置一个代理服务器(域名与domain1相同,端口不同)做跳板机,反向代理访问domain2接口,并且可以顺便修改cookie中domain信息,方便当前域cookie写入,实现跨域登录。
nginx具体配置
#proxy服务器
server {
    listen       81;
    server_name  www.domain1.com;

    location / {
        proxy_pass   http://www.domain2.com:8080;  #反向代理
        proxy_cookie_domain www.domain2.com www.domain1.com; #修改cookie里域名
        index  index.html index.htm;

        # 当用webpack-dev-server等中间件代理接口访问nignx时,此时无浏览器参与,故没有同源限制,下面的跨域配置可不启用
        add_header Access-Control-Allow-Origin http://www.domain1.com;  #当前端只跨域不带cookie时,可为*
        add_header Access-Control-Allow-Credentials true;
    }
}
前端代码
var xhr = new XMLHttpRequest();

// 前端开关:浏览器是否读写cookie
xhr.withCredentials = true;

// 访问nginx中的代理服务器
xhr.open('get', 'http://www.domain1.com:81/?user=admin', true);
xhr.send();
Node.js后台示例
var http = require('http');
var server = http.createServer();
var qs = require('querystring');

server.on('request', function(req, res) {
    var params = qs.parse(req.url.substring(2));

    // 向前台写cookie
    res.writeHead(200, {
        'Set-Cookie': 'l=a123456;Path=/;Domain=www.domain2.com;HttpOnly'   // HttpOnly:脚本无法读取
    });

    res.write(JSON.stringify(params));
    res.end();
});

server.listen('8080');
console.log('Server is running at port 8080...');
3.vue框架的跨域(1次跨域)
vue.config.js文件内配置跨域
module.exports = {
  devServer: {
    proxy:{
      '/api':{
          target:'http://localhost:9000',
          secure:false,
          changeOrigin:true,
          pathRewrite:{
              '^/api':'/'
          }
      }
    }
  }
}
main.js
Vue.prototype.$http = axios // 可变换
axios.defaults.baseURL = '/api'
4. 关于“性能优化”知道多少?关于 TreeShaking 知道多少?
1.减少HTTP请求
一个完整的 HTTP 请求需要经历 DNS 查找,TCP 握手,浏览器发出 HTTP 请求,服务器接收请求,服务器处理请求并发回响应,浏览器接收响应并下载资源;这也是将多个小文件合并为一个大文件,从而减少 HTTP 请求次数的原因
2. 使用HTTP2.0
解析速度更快:服务器解析 HTTP1.1 的请求时,必须不断地读入字节,直到遇到分隔符 CRLF 为止。而解析 HTTP2 的请求就不用这么麻烦,因为 HTTP2 是基于帧的协议,每个帧都有表示帧长度的字段。
多路复用:HTTP1.1 如果要同时发起多个请求,就得建立多个 TCP 连接,因为一个 TCP 连接同时只能处理一个 HTTP1.1 的请求。在 HTTP2 上,多个请求可以共用一个 TCP 连接,这称为多路复用。同一个请求和响应用一个流来表示,并有唯一的流 ID 来标识;多个请求和响应在 TCP 连接中可以乱序发送,到达目的地后再通过流 ID 重新组建。
首部压缩:将请求中相同的首部存储起来,根据首部值创建一张表,只需要发送表的索引即可,服务端也许创建索引相对应的表进行检索
请求优先级设置:HTTP2 可以对比较紧急的请求设置一个较高的优先级,服务器在收到这样的请求后,可以优先处理。
流量控制:一个 TCP 连接流量带宽(根据客户端到服务器的网络带宽而定)是固定的,当有多个请求并发时,一个请求占的流量多,另一个请求占的流量就会少。流量控制可以对不同的流的流量进行精确控制。
服务器推送:HTTP2 新增的一个强大的新功能,就是服务器可以对一个客户端请求发送多个响应。换句话说,除了对最初请求的响应外,服务器还可以额外向客户端推送资源,而无需客户端明确地请求。
3. 使用服务端渲染
客户端渲染:获取HTML文件,根据需要下载JavaScript文件,运行文件,生成DOM,再渲染。
服务端渲染:**服务端返回HTML文件,客户端只需解析HTML.**服务器会查看当前路由组件需要哪些资源文件,然后将这些文件的内容填充到 HTML 文件。如果有 ajax 请求,就会执行它进行数据预取并填充到 HTML 文件里,最后返回这个 HTML 页面
4. 静态资源使用CDN
5. 将CSS放在文件头部,JavaScript文件放在底部
- CSS执行会阻塞渲染,阻止JS执行
- JS加载和执行会阻塞HTML解析,阻止CSSOM构建
- 如果这些 CSS、JS 标签放在 HEAD 标签里,并且需要加载和解析很久的话,那么页面就空白了。所以 JS 文件要放在底部(不阻止 DOM 解析,但会阻塞渲染),等 HTML 解析完了再加载 JS 文件,尽早向用户呈现页面的内容。
- 先加载 HTML 再加载 CSS,会让用户第一时间看到的页面是没有样式的、“丑陋”的,为了避免这种情况发生,就要将 CSS 文件放在头部了。
- JS 文件也不是不可以放在头部,只要给 script 标签加上 defer 属性就可以了,异步下载,延迟执行。
6. 图片懒加载
其他前端优化方案
5. XSS和CSRF的原理、预防机制
XSS
XSS,即 Cross Site Script,中译是跨站脚本攻击;其原本缩写是 CSS,但为了和层叠样式表(Cascading Style Sheet)有所区分,因而在安全领域叫做 XSS。
XSS攻击是指攻击者在网站上注入恶意的客户端代码,通过恶意脚本对客户端网页进行篡改,从而在用户浏览网页时,对用户浏览器进行控制或者获取用户隐私数据的一种攻击方式。
攻击者对客户端网页注入的恶意脚本一般包括 JavaScript,有时也会包含 HTML 和 Flash。有很多种方式进行 XSS 攻击,但它们的共同点为:将一些隐私数据像 cookie、session 发送给攻击者,将受害者重定向到一个由攻击者控制的网站,在受害者的机器上进行一些恶意操作。
XSS攻击可以分为3类:反射型(非持久型)、存储型(持久型)、基于DOM
反射型
反射型 XSS 只是简单地把用户输入的数据 “反射” 给浏览器,这种攻击方式往往需要攻击者诱使用户点击一个恶意链接,或者提交一个表单,或者进入一个恶意网站时,注入脚本(返回script里嵌套的脚本,对用户网站进行相应控制)进入被攻击者的网站。
存储型
存储型XSS 会把用户输入的数据 “存储” 在服务器端,当浏览器请求数据时,脚本从服务器上传回并执行。这种 XSS 攻击具有很强的稳定性。比较常见的一个场景是攻击者在社区或论坛上写下一篇包含恶意 JavaScript 代码的文章或评论,文章或评论发表后(影响了后续用户),所有访问该文章或评论的用户,都会在他们的浏览器中执行这段恶意的 JavaScript 代码
基于DOM
基于DOM的XSS攻击是指通过恶意脚本修改页面的DOM结构,是纯粹发生在客户端的攻击。
XSS攻击防范
- 现在主流的浏览器内置了防范 XSS 的措施,例如 CSP。
HttpOnly防止截取Cookie
HttpOnly 最早由微软提出,至今已经成为一个标准。浏览器将禁止页面的Javascript访问带有 HttpOnly 属性的Cookie。所以给Cookie携带上HttpOnly属性可以防止Cookie本身被恶意劫持使用。
输入检查
不相信用户的任何输入,对于用户的任何输入要进行检查、过滤和转义。建立可信任的字符和 HTML 标签白名单,对于不在白名单之列的字符或者标签进行过滤或编码。
在一些前端框架中,都会有一份 decodingMap, 用于对用户输入所包含的特殊字符或标签进行编码或过滤,如 <,>,script,防止 XSS 攻击:
// vuejs 中的 decodingMap
// 在 vuejs 中,如果输入带 script 标签的内容,会直接过滤掉
const decodingMap = {
'<': '<',
'>': '>',
'"': '"',
'&': '&',
'
': '\n'
}CSRF
CSRF,即 Cross Site Request Forgery,中译是跨站请求伪造,是一种劫持受信任用户向服务器发送非预期请求的攻击方式。
通常情况下,CSRF 攻击是攻击者借助受害者的 Cookie 骗取服务器的信任,可以在受害者毫不知情的情况下以受害者名义伪造请求发送给受攻击服务器,从而在并未授权的情况下执行在权限保护之下的操作。
浏览器的Cookie策略
Cookie 是服务器发送到用户浏览器并保存在本地的一小块数据,它会在浏览器下次向同一服务器再发起请求时被携带并发送到服务器上。
浏览器所持有的 Cookie 分为两种:
- Session Cookie(会话期 Cookie):会话期 Cookie 是最简单的Cookie,它不需要指定过期时间(Expires)或者有效期(Max-Age),它仅在会话期内有效,浏览器关闭之后它会被自动删除。
- Permanent Cookie(持久性 Cookie)硬盘Cookie:与会话期 Cookie 不同的是,持久性 Cookie 可以指定一个特定的过期时间(Expires)或有效期(Max-Age)
每个 Cookie 都会有与之关联的域,这个域的范围一般通过 domain 属性指定。如果 Cookie 的域和页面的域相同,那么我们称这个 Cookie 为第一方 Cookie(first-party cookie),如果 Cookie 的域和页面的域不同,则称之为第三方 Cookie(third-party cookie)。
通过Cookie进行CSRF攻击
Cookie 中包含了用户的认证信息,当用户访问攻击者准备的攻击环境时,攻击者就可以对服务器发起 CSRF 攻击。在这个攻击过程中,攻击者借助受害者的 Cookie 骗取服务器的信任,但并不能拿到 Cookie,也看不到 Cookie 的内容。而对于服务器返回的结果,由于浏览器同源策略的限制,攻击者也无法进行解析。因此,攻击者无法从返回的结果中得到任何东西,他所能做的就是给服务器发送请求(冒用用户的身份,给服务器发送请求),以执行请求中所描述的命令,在服务器端直接改变数据的值,而非窃取服务器中的数据。
CSRF攻击的防范
1. 验证码
验证码被认为是对抗 CSRF 攻击最简洁而有效的防御方法。
验证码会强制用户必须与应用进行交互,才能完成最终请求。因为通常情况下,验证码能够很好地遏制 CSRF 攻击。
出于用户考虑,不能给网站所有的操作都加上验证码。因此,验证码只能作为防御 CSRF 的一种辅助手段,而不能作为最主要的解决方案。
2. Refer Check
根据 HTTP 协议,在 HTTP 头中有一个字段叫 Referer,它记录了该 HTTP 请求的来源地址。通过 Referer Check,可以检查请求是否来自合法的”源”。
可在服务端添加以下代码验证请求来源:
if (req.headers.referer !== 'http://www.c.com:8002/') {
    res.write('csrf 攻击');
    return;
}
Referer Check 不仅能防范 CSRF 攻击,另一个应用场景是 “防止图片盗链”。
3. 添加token验证(cookie和token的结合使用)
CSRF 攻击之所以能够成功,是因为攻击者可以完全伪造用户的请求,该请求中所有的用户验证信息都是存在于 Cookie 中,因此攻击者可以在不知道这些验证信息的情况下直接利用用户自己的 Cookie 来通过安全验证。要抵御 CSRF,关键在于在请求中放入攻击者所不能伪造的信息,并且该信息不存在于 Cookie 之中。可以在 HTTP 请求中以参数的形式加入一个随机产生的 token,并在服务器端建立一个拦截器来验证这个 token,如果请求中没有 token 或者 token 内容不正确,则认为可能是 CSRF 攻击而拒绝该请求。
6. 设置Cookie时只SameSite能够生效吗?需不需要其他属性的配合?
7. tcp,udp为什么三次握手,四次挥手
①因为当Server端收到Client端的SYN连接请求报文后,可以直接发送SYN+ACK报文。其中ACK报文是用来应答的,SYN报文是用来同步的。
②但是关闭连接时,当Server端收到FIN报文时,很可能并不会立即关闭SOCKET,所以只能先回复一个ACK报文,告诉Client端,“你发的FIN报文我收到了”。
③只有等到我Server端所有的报文都发送完了,我才能发送FIN报文,因此不能一起发送。故需要四步握手。
————————————————
版权声明:本节为CSDN博主「辰兮要努力」的原创文章
原文链接:https://blog.csdn.net/weixin_45393094/article/details/104965561
8. display:none和visibility:hidden
display: none;:元素消失,不占位,不影响ol-li元素的计数,触发回流;
visibility: hidden;:元素隐藏,占位,若在ol-li中,依然进行计数,触发重绘;
9. CSS盒模型,BFC
- 块级元素的外边距重叠,浮动元素产生的元素重叠、父元素高度塌陷等,都可以通过设置BFC解决
- 激活BFC(取消影响的方法):
- div包裹
- overflow: hidden;或overflow: auto;
- float: left / right
- display: inline-block / table-caption / table-cell
10. 重绘与回流
回流:样式的修改影响了页面布局,回流一定重绘;
重绘:样式修改不影响页面布局,如字体颜色设置,背景颜色的设置,重绘不一定回流;
11. 行内元素与块级元素的区别
12. 路由hash与history模式
最直观的区别就是hash路由有一个 # 号,而history是没有的
hash路由
hash模式下,它指 # 号之后的所有字符,但是他虽然包含在url中,但是不包含在http请求中。所以改变hash值不会重新加载页面,对传给后端的url没有任何影响,因此不会重新加载页面。每次改变都会触发hashchange事件,可以通过给window加上hashchange事件进行监听。
history路由
history模式,利用了 HTML5 新增的 pushState() 和 replaceState() 方法,在原有的back、forward、go 的基础上,添加对历史记录修改的功能。他虽然改变了url,但是浏览器不会立即向后端发送请求。
13. keep-alive有什么作用?
keep-alive可以在组件切换时,保存其包裹的组件的状态,使其不被销毁,防止多次渲染。其拥有两个独立的生命周期钩子函数 actived 和 deactived,使用keep-alive包裹的组件在切换时不会被销毁,而是缓存到内存中并执行 deactived 钩子函数,命中缓存渲染后会执行 actived 钩子函数。
<keep-alive include="a">
  <component>
    <!-- name 为 a 的组件将被缓存! -->
  </component>
</keep-alive>可以保留它的状态或避免重新渲染<keep-alive exclude="a">
<component>
<!-- 除了 name 为 a 的组件都将被缓存! -->
</component>
</keep-alive>可以保留它的状态或避免重新渲染实际项目中常常结合router的meta属性使用
<keep-alive>
  <router-view v-if="$route.meta.keepAlive" />
</keep-alive>
<router-view v-if="!$route.meta.keepAlive" />
14. IPv4分址
IPv4分类
IPv4地址由四段组成,每个字段是一个字节,8位,最大值是255
IPv4地址由两部分组成,即网络地址和主机地址。网络地址表示其属于互联网的哪一个网络,主机地址表示其属于该网络中的哪一台主机,二者是主从关系。
IPv4地址的四大类型标识的是网络中的某台主机。IPv4地址长度为32位,共4个字节,但实际中我们用**点分十进制(4个8位代表0-255)**记法,将IP转换成二进制值

IPv4地址根据网络号和主机号来分,分为A、B、C三类及特殊地址D、E。全0和全1的都保留不用,如A类中的0.0.0.0和127.255.255.255都不使用。
A类:(1.0.0.1-126.255.255.254)(默认子网掩码:255.0.0.0或0xFF000000)第一个字节为网络号,后三个字节为主机号,表示为网络--主机--主机--主机。该类IP地址的最前面为**“0”,所以地址的网络号取值于1~126(七位网络号:0000001-1111110)之间。每个网络号共有16777214(2^24-2)**个主机地址,一般用于大型网络。
B类:(128.1.0.1-191.254.255.254)(默认子网掩码:255.255.0.0或0xFFFF0000)前两个字节为网络号,后两个字节为主机号。该类IP地址的最前面为**“10”,所以地址的网络号取值于128~191(10000000-10111110)之间。共有65534(2^16-2)**个主机地址,一般用于中等规模网络。
C类:(192.0.1.1-223.255.254.254)(子网掩码:255.255.255.0或0xFFFFFF00)前三个字节为网络号,最后一个字节为主机号。该类IP地址的最前面为**“110”,所以地址的网络号取值于192~223(11000000-11011110)之间。共有254(2^8-2)**个主机地址,一般用于小型网络。
D类:是多播地址。(224.0.0.1-239.255.255.254) 该类IP地址的前面4位为**“1110”,所以网络号取值于224~239(11100000-11101111)之间;后面28位为组播地址ID**。这是一个专门保留的地址。它并不指向特定的网络,目前这一类地址被用在多点广播(Multicasting)中。多点广播地址用来一次寻址一组计算机,它标识共享同一协议的一组计算机。
E类:是保留地址,为将来使用保留。(240.0.0.0---255.255.255.254) 该类IP地址的最前面为“1111”,所以网络号取值于240~255之间。
注意:所有的网络空间计算都必须 -2,这是因为要扣除两个保留地址:
主机号全部为1的地址是子网广播地址,如:192.168.1.255 ;
主机号全部为0的地址是代表该子网的网络地址,如:192.168.1.0 ;
1-254才是给主机使用的
虚拟IP
众所皆知的,IPv4 地址仅为 xxx.xxx.xxx.xxx 的资料型态,其中,xxx 为 1-255 间的整数,由于计算机的成长速度太快,实体的 IP 已经有点不足了。
好在早在规划 IP 时就已经预留了三个网段的 IP 做为内部网域的虚拟 IP 之用。这三个预留的 IP 分别为:
A级:10.0.0.1 - 10.255.255.254
B级:172.16.0.1 - 172.31.255.254
C级:192.168.0.1 - 192.168.255.254
上述中最常用的是192.168.0.0这一组。不过,由于是虚拟 IP ,所以当您使用这些地址的时候﹐当然是有所限制的,限制如下:
私有位址的路由信息不能对外散播。使用私有位址作为来源或目的地址的封包,不能透过Internet来转送。
关于私有位址的参考纪录(如DNS),只能限于内部网络使用。
版权声明:本节为CSDN博主「D_R_L_T」的原创文章,遵循CC 4.0 BY-SA版权协议,转载请附上原文出处链接及本声明。
原文链接:https://blog.csdn.net/D_R_L_T/article/details/96606543
15. 虚拟DOM的diff算法
通过key来匹配新旧节点,匹配后期新增未匹配到的节点,移除未匹配到的旧节点
虚拟DOM
- 虚拟DOM === VNode(Virtual Node),无论是组件还是元素,它们最终在Vue中表示出来的都是一个个VNode
- 如果我们不只是一个简单的div,而是有一大堆的元素,那么它们应该会形成一个VNode Tree
列表数据插入(无key)
没有v-for遍历数据没有key值的情况下,插入一个节点:

对于不匹配的新旧节点将直接进行修改,事实上,c、d节点没有必要进行修改,直接在c节点之前进行添加节点即可实现效果,无key的方式耗费了不必要的性能。
列表数据插入(有key)
1. 头部遍历,遇到不同,进入下一步

2. 尾部遍历,遇到不同,进入下一步

3. 旧节点遍历完毕,仍有新节点,新增该节点

4. 新节点遍历完毕,仍有旧节点,移除该节点

5. 乱序节点匹配,新增未匹配到的新节点,移除未匹配到的旧节点

16. vuex的mutations和actions
import vue from 'vue'
import Vuex from 'vuex'

vue.use(Vuex)

const store = new Vuex.Store({ //Vuex.Store()
  state: {
    counter: 10000,
    idle: [
      { name: 'zjf', age: 21 },
      { name: 'zj', age: 19 },
      { name: 'zf', age: 23 },
      { name: 'jf', age: 18 },
    ],
    info: {
      name: 'kobe'
    }
  },
  mutations: {  //改变store的数据的唯一方式就是提交mutations!
    increment(state) { //事件类型加回调函数,state为第一个参数,还可传其他参数
      state.counter++
    },
    decrement(state) {
      state.counter--
    },
    updateInfo(state) { //由actions中的异步提交的修改
      state.info.name = 'zjf'
    }
  },
  getters: { //返回对store后处理后的数据,相当于计算属性
    powerCounter(state) {
      return state.counter * state.counter;
    }
  },
  actions: {
    aUpdateData(context, data) {//接收异步消息
      return new Promise((resolve, reject) => { //promise实现异步接收
        setTimeout(() => {
          context.commit('updateInfo');
          console.log(data);
          resolve('传给App.vue的数据')
        }, 1000);
      })
    }
  },
  modules: {}
})

export default store<template>
<div id="app">
<button @click="changeData">异步修改</button>
<h2>{{ $store.state.info }}</h2>
<h2>getters改变得到的{{ $store.getters.powerCounter }}</h2>
</div>
</template>
<script>
export default {
name: "App",
data() {
return {
message: "app message",
};
},
components: {
HelloWorld,
},
methods: {
//提交修改
addition() { // 通过提交commit来调用mutations里的方法
this.$store.commit("increment"); //提交事件类型
},
substraction() {
this.$store.commit("decrement");
},
changeData() {
// this.$store.dispatch("aUpdateData", "actions submit"); //提交异步修改
this.$store.dispatch("aUpdateData", "传给actions的数据").then((res) => {
console.log(res);
});
},
},
};
</script>17. 二叉树遍历
前序遍历:
根节点 -> 左节点 -> 右节点
中序遍历
左节点 -> 中间节点 -> 右节点
后序遍历
左节点 -> 右节点 -> 中间节点
18. 说说html5和css3新特性
html5: 语义化标签,媒体标签audio,video
css3:
- 属性选择器E[att="val"] -> 选择E元素中具有arr属性且值位val的元素
- 结构伪类选择器: E: first-child、E: last-child、E: nth-child(n)、E: first-of-type、E: last-of-type、E: nth-of-type(n) n: 2n、2n+1、5n、n+5、-n+5
- 伪元素选择器 ::before ::after 伪元素可用于清除浮动
.clearfix:after {
	content: ""; // 伪元素必写特性
	display: block; // 插入的元素必须是块级元素
	height: 0; // 不要看见这个元素
	clear: both; // 清除浮动
	visibility: hidden; // 不要看见这个元素
}- 盒子模型 BFC
- 模糊处理: filter: blur(5px); backdrop-filter: blur(5px); 毛玻璃
- calc动态计算属性
- transition过渡属性:transition: 要过渡的属性 花费时间 运动曲线 何时开始;
版权声明:本节为CSDN博主「吴大喜」的原创文章
原文链接:https://blog.csdn.net/wmz19960227/article/details/122410421
19. null和undefined的区别
typeof(null) === 'object';

typeof(undefined) === undefined;1、null是关键字,而undefined不是关键字;
2、undefined和null被转换为布尔值的时候,两者都为false;
3、undefined在和null进行**==比较时两者相等**,全等于比较时两者不等;
4、使用Number()对undefined和null进行类型转换
5、undefined本质上是window的一个属性,而null是一个对象;
6、undefined和null的用途 null是顶层原型的原型,使用的变量不存在为undefined,函数默认返回undefined
20. 构造函数的种类
构造函数可不可以为虚函数,也不可以是箭头函数。
function foo(){} // new.target判断是否是通过new调用,或this.instanceof(foo)判断
class
21. 线程与进程的区别
进程是一个具有一定独立功能的程序关于某个数据集合的一次运行活动,我们打开浏览器,实际上就是打开了一个进程,它就会被载入内存空间,并在逻辑上产生一个独立的实例,子进程和父进程有不同的代码和数据空间
线程(英语:thread)是操作系统能够进行运算调度的最小单位,一条线程指的是进程中一个单一顺序的控制流,一个进程中可以并发多个线程,每条线程并行执行不同的任务。多个线程则共享一个数据空间
22. TCP与UDP的区别
TCP是面向连接的,UDP是无连接的
TCP是可靠的,UDP是不可靠的
TCP是面向字节流的,UDP是面向数据报文的
TCP只支持点对点通信,UDP支持一对一,一对多,多对多
TCP报文首部20个字节,UDP首部8个字节
TCP有拥塞控制机制,UDP没有
TCP协议下双方发送接受缓冲区都有,UDP并无实际意义上的发送缓冲区,但是存在接受缓冲区
23. map和forEach的区别
相同点:map和forEach都是遍历数组,匿名函数中this指向window,都支持三个参数item,index,arr(原数组);
不同点:map()会分配内存空间存储新数组并返回,forEach不会返回数据;forEach()允许callback更改原始数组的元素
let arr = [1, 2, 3, 4, 5];
let arr2 = arr.map(value => value ** value).filter(value => value > 1);
console.log('arr=', arr); // arr= [ 1, 2, 3, 4, 5 ]
console.log('arr2=', arr2); // arr2= [ 4, 27, 256, 3125 ]
var arr = [1, 2, 3, 4, 5];
var sum = 0;
var str = arr.forEach(function(item, index, arr) {
sum += item;
}, this)
console.log("str=", str); // str = undefined
console.log("sum=", sum); // sum = 1524. 数组拷贝的方法(以下均是浅拷贝)
1. const newArr = [...arr];
2. const newArr = [].concat(arr);
3. const newArr = JSON.parse(JSON.stringify(arr));
4. const newArr = arr.slice(0);
25. 内存泄漏
1. 创建全局变量
由于 js 对未声明变量的处理方式是在全局对象上创建该变量的引用。如果在浏览器中,全局对象就是 window 对象。变量在窗口关闭或重新刷新页面之前都不会被释放,如果未声明的变量缓存大量的数据,就会导致内存泄露。
function fn() {
  a = global variable;
}
fn();
function fn() {
this.a = global variable; // window.a
}
fn();尽量避免创建全局变量,使用"use strict进行规范"
2. 闭包引起内存泄漏
fucntion fn() {
  var a = 'zjf';
  return function() {
    console.log(a)
  }
}
fn(); // 使用a
可将事件处理函数定义在外部
function fn() {
  var a = 'zjf';
  foo(a);
}
function foo(a) {
  console.log(a);
}
fn();
3. DOM元素引用未清除
v-if 绑定到 false 的值,但是实际上 dom 元素在隐藏的时候没有被真实的释放掉。
手动清除或销毁元素
4. 定时器或回调未被清除
vue中使用了定时器的话,可以在destroyed生命周期里对定时器进行销毁
26. 输入URL到页面显示的过程
- 首先,在浏览器地址栏中输入url
- 浏览器先查看页面缓存:浏览器缓存-系统缓存-路由器缓存,如果缓存中有,会直接在屏幕中显示页面内容。若没有,则跳到第三步操作。
- 在发送http请求前,需要域名解析(DNS解析),解析获取相应的IP地址。
- 浏览器向服务器发起tcp连接,与浏览器建立tcp三次握手。
- 握手成功后,浏览器向服务器发送http请求,请求数据包。
- 服务器处理收到的请求,将数据返回至浏览器
- 浏览器收到HTTP响应
- 读取页面内容,浏览器渲染,解析html源码
- 生成Dom树、解析css样式
27. 行内元素与块级元素
块级元素会独占一行,其宽度自动填满其父元素宽度,能够自动换行开启新的一行,能够设置宽高,margin和padding对上下左右四个方向设置均有效;
常见块级元素:div,p,pre,h1~h6,ul-li,ol-li,dl-dt-dd,form,body,table,menu
行内元素指的是书写完成后不会自动换行,并且元素没有宽和高,margin和padding设置左右有效,上下设置无效,
常见行内元素:a,span,strong,b,em,i,label
行内块元素可设置宽高不换行
常见的行内块元素:img,textarea,button,input,select
28. 常见http状态码(重要)

29. vue组件的几种通信方式1
1. props/$emit
2. $parent,$root/$children,$refs
3. $attrs/$listeners
4. provide/inject
5. $emit/$on
6. vuex
30. Content-Type
Content-Type,内容类型,一般是指网页中存在的Content-Type,用于定义网络文件的类型和网页的编码,决定浏览器将以什么形式、什么编码读取这个文件
常见的媒体格式类型如下:
text/html : HTML格式
text/plain :纯文本格式
text/xml : XML格式
image/gif :gif图片格式
image/jpeg :jpg图片格式
image/png:png图片格式
以application开头的媒体格式类型:
以application开头的媒体格式类型:
application/xhtml+xml :XHTML格式
application/xml : XML数据格式
application/atom+xml :Atom XML聚合格式
application/json : JSON数据格式
application/pdf :pdf格式
application/msword : Word文档格式
application/octet-stream : 二进制流数据(如常见的文件下载)
application/x-www-form-urlencoded : 中默认的encType,form表单数据被编码为key/value格式发送到服务器(表单默认的提交数据的格式)
常见的媒体格式是上传文件之时使用的:
multipart/form-data : 需要在表单中进行文件上传时,就需要使用该格式 以上就是我们在日常的开发中,经常会用到的若干content-type的内容格式。
31. JS阻塞DOM渲染
- css解析(CSSOM树的生成)将会阻塞渲染树(render tree由DOM节点树和CSSOM树组成)的生成,进而阻塞DOM的渲染;
- js将会阻塞DOM解析;
32. css对不同浏览器的适代码
-webkit-:主要兼容的浏览器是:谷歌的Chrome和苹果的Safari浏览器;
-ms-:主要兼容的浏览器是:微软的Internet Explorer、Edge浏览器;
-moz-:主要兼容的浏览器是:火狐的Firefox浏览器;
-o-:主要兼容的浏览器是:欧朋的Opera浏览器
div
{
transform: rotate(45deg);
transform-origin:20% 40%;

-webkit-transform: rotate(45deg);	/* Safari 和 Chrome */ -webkit-
-webkit-transform-origin:20% 40%;	/* Safari 和 Chrome */

-ms-transform: rotate(45deg); 		/* IE 9 */ -ms-
-ms-transform-origin:20% 40%; 		/* IE 9 */

-moz-transform: rotate(45deg);		/* Firefox */ -moz-
-moz-transform-origin:20% 40%;		/* Firefox */

-o-transform: rotate(45deg);		/* Opera */ -o-
-o-transform-origin:20% 40%;		/* Opera */
}
33. HTTPS
HTTPS(全称:Hyper Text Transfer Protocol over Secure Socket Layer),是以安全为目标的HTTP通道,简单讲是HTTP的安全版。
通过SSL或TLS提供加密处理数据、验证对方身份以及数据完整性保护
HTTPS相当于在HTTP下加入SSL层,HTTPS的安全基础是SSL,因此加密的详细内容就需要SSL。 它是一个URI scheme(抽象标识符体系),句法类同http:体系。用于安全的HTTP数据传输。
https:URL表明它使用了HTTP,但**HTTPS存在不同于HTTP的默认端口(HTTP为80端口,HTTPS为443端口)**及一个加密/身份验证层(在HTTP与TCP之间)。
HTTPS可以避免第三方窃听或阻断流量,保护用户的隐私和安全,提升口碑。此外,谷歌开始针对启用HTTPS网站给予更高的搜索引擎权重,可以提升网站流量。另外HTTPS能够更好的保护网站数据独享,在如今这个大数据时代,数据就是财富。
34. jpg和png有什么区别
- jpg是有损压缩格式,png是无损压缩格式。jpg是jpeg的简称,是目前网络上最为流行的图片格式,jpg格式的图片可以将图像文件压缩到最小格式,png全称为Portable Network Graphics,翻译过来是'便携式网络图形',它是一种无损压缩的图片格式;
- jpg图像没有透明的背景,而png图像可以保留透明的背景;
- jpg格式的图片不可编辑修改,png格式的图片可以通过PS进行编辑;
- jpg与png图片相比,png格式的图片更大。
35. JS小数计算精度问题
js number类型运算都需要先将十进制转二进制,小数点后的位数转二进制会出现无限循环的问题,只能舍0入1,所以会出现小数点丢失问题.
解决方法:
(0.1 + 0.2).toFixed(2); // typeof (0.1 + 0.2).toFixed(2); 'string' "0.30"(0.1*10 + 0.2*10)/10; // 0.3
36. OSI网络分层(七层)和TCP/IP五层模型
OSI七层模型
概念:
- OSI(Open System Interconnection,开放系统互连)七层网络模型称为开放式系统互联参考模型
- 把网络从逻辑上分为了7层. 每一层都有相关、相对应的物理设备。
- OSI七层网络模型最主要的功能使就是帮助不同类型的主机实现数据传输。

- 第一层 (物理层): 是以0101的二进制数据进行发送到网络其他设备中的
- 第二层 (数据链路层): 实现网络互联,连接到不同的主机,不同主机之间还要进行数据传输
- 第三层 (网络层): 网络地址IP使用,通过路由器传送到对应的地方
- 第四层 (传输层): TCP/UDP协议:都是属于操作系统
- 第五层 (会话层): 通信管理,负责建立和断开通信连接。
- 第六层 (表示层): 主要是应用程序的沟通,包括FTP文件传输协议等
七层模型在落地时第五层(会话层)和第六层(表示层)实现不了,它既复杂又不实用; 所以我们按照TCP/IP五层模型来讲解。OSI七层模型去掉会话层和表示层就成为TCP/IP的五层模型了
TCP/IP五层模型

- 物理层:负责光/电信号的传递方式. 比如现在以太网通用的网线(双绞 线)、早期以太网采用的的同轴电缆(现在主要用于有线电视)、光纤, 现在的wifi无线网使用电磁波等都属于物理层的概念。物理层的能力决定了最大传输速率、传输距离、抗干扰性等. 集线器(Hub)工作在物理层.
- 数据链路层: 负责设备之间的数据帧的传送和识别. 例如网卡设备的驱动、帧同步(就是说从网线上检测到什么信号算作新帧的开始)、冲突检测(如果检测到冲突就自动重发)、数据差错校验等工作. 有以太网、令牌环网, 无线LAN等标准. 交换机(Switch)工作在数据链路层.
- 网络层:负责地址管理和路由选择. 例如在IP协议中, 通过IP地址来标识一台主机, 并通过路由表的方式规划出两台主机之间的数据传输的线路(路由). 路由器(Router)工作在网路层.
- 传输层: 负责两台主机之间的数据传输. 如传输控制协议 (TCP), 能够确保数据可靠的从源主机发送到目标主机.
- 应用层: 负责应用程序间沟通,如简单电子邮件传输(SMTP)、文件传输协议(FTP)、网络远程访问协议(Telnet)等. 我们的网络编程主要就是针对应用层
37. CSS预处理工具(less,sass)
CSS预处理工具是一种语言,用来为CSS增加一些编程的特性,无需考虑到浏览器的兼容性问题
可以在CSS中使用变量、简单的程序逻辑、函数等等在编程语言的一些基本技巧,可以让你的CSS更加简洁,适应性更强,代码更直观等诸多好处
目前主要有三种主流css预处理工具:less,stylus,sass
38. 正则匹配
| \ | 将下一字符标记为特殊字符、文本、反向引用或八进制转义符。例如,"n"匹配字符"n"。"\n"匹配换行符。序列"\"匹配"","("匹配"("。 |
|---|---|
| ^ | 匹配输入字符串开始的位置。如果设置了 RegExp 对象的 Multiline 属性,^ 还会与"\n"或"\r"之后的位置匹配。 |
| $ | 匹配输入字符串结尾的位置。如果设置了 RegExp 对象的 Multiline 属性,$ 还会与"\n"或"\r"之前的位置匹配。 |
| * | 零次或多次匹配前面的字符或子表达式。例如,zo* 匹配"z"和"zoo"。* 等效于 {0,}。 |
| + | 一次或多次匹配前面的字符或子表达式。例如,"zo+"与"zo"和"zoo"匹配,但与"z"不匹配。+ 等效于 {1,}。 |
| ? | 零次或一次匹配前面的字符或子表达式。例如,"do(es)?"匹配"do"或"does"中的"do"。? 等效于 {0,1}。 |
| {n} | n 是非负整数。正好匹配 n 次。例如,"o{2}"与"Bob"中的"o"不匹配,但与"food"中的两个"o"匹配。 |
| {n,} | n 是非负整数。至少匹配 n 次。例如,"o{2,}"不匹配"Bob"中的"o",而匹配"foooood"中的所有 o。"o{1,}"等效于"o+"。"o{0,}"等效于"o*"。 |
| {n,m} | m 和 n 是非负整数,其中 n <= m。匹配至少 n 次,至多 m 次。例如,"o{1,3}"匹配"fooooood"中的头三个 o。'o{0,1}' 等效于 'o?'。注意:您不能将空格插入逗号和数字之间。 |
| ? | 当此字符紧随任何其他限定符(、+、?、{*n}、{n,}、{n,m})之后时,匹配模式是"非贪心的"。"非贪心的"模式匹配搜索到的、尽可能短的字符串,而默认的"贪心的"模式匹配搜索到的、尽可能长的字符串。例如,在字符串"oooo"中,"o+?"只匹配单个"o",而"o+"匹配所有"o"。 |
| . | 匹配除"\r\n"之外的任何单个字符。若要匹配包括"\r\n"在内的任意字符,请使用诸如"[\s\S]"之类的模式。 |
| (pattern) | 匹配 pattern 并捕获该匹配的子表达式。可以使用 |
| (?:pattern) | 匹配 pattern 但不捕获该匹配的子表达式,即它是一个非捕获匹配,不存储供以后使用的匹配。这对于用"or"字符 (|) 组合模式部件的情况很有用。例如,'industr(?:y|ies) 是比 'industry|industries' 更经济的表达式。 |
| (?=pattern) | 执行正向预测先行搜索的子表达式,该表达式匹配处于匹配 pattern 的字符串的起始点的字符串。它是一个非捕获匹配,即不能捕获供以后使用的匹配。例如,'Windows (?=95|98|NT|2000)' 匹配"Windows 2000"中的"Windows",但不匹配"Windows 3.1"中的"Windows"。预测先行不占用字符,即发生匹配后,下一匹配的搜索紧随上一匹配之后,而不是在组成预测先行的字符后。 |
| (?!pattern) | 执行反向预测先行搜索的子表达式,该表达式匹配不处于匹配 pattern 的字符串的起始点的搜索字符串。它是一个非捕获匹配,即不能捕获供以后使用的匹配。例如,'Windows (?!95|98|NT|2000)' 匹配"Windows 3.1"中的 "Windows",但不匹配"Windows 2000"中的"Windows"。预测先行不占用字符,即发生匹配后,下一匹配的搜索紧随上一匹配之后,而不是在组成预测先行的字符后。 |
| x|y | 匹配 x 或 y。例如,'z|food' 匹配"z"或"food"。'(z|f)ood' 匹配"zood"或"food"。 |
| [xyz] | 字符集。匹配包含的任一字符。例如,"[abc]"匹配"plain"中的"a"。 |
| [^xyz] | 反向字符集。匹配未包含的任何字符。例如,"[^abc]"匹配"plain"中"p","l","i","n"。 |
| [a-z] | 字符范围。匹配指定范围内的任何字符。例如,"[a-z]"匹配"a"到"z"范围内的任何小写字母。 |
| [^a-z] | 反向范围字符。匹配不在指定的范围内的任何字符。例如,"[^a-z]"匹配任何不在"a"到"z"范围内的任何字符。 |
| \b | 匹配一个字边界,即字与空格间的位置。例如,"er\b"匹配"never"中的"er",但不匹配"verb"中的"er"。 |
| \B | 非字边界匹配。"er\B"匹配"verb"中的"er",但不匹配"never"中的"er"。 |
| \cx | 匹配 x 指示的控制字符。例如,\cM 匹配 Control-M 或回车符。x 的值必须在 A-Z 或 a-z 之间。如果不是这样,则假定 c 就是"c"字符本身。 |
| \d | 数字字符匹配。等效于 [0-9]。 |
| \D | 非数字字符匹配。等效于 [^0-9]。 |
| \f | 换页符匹配。等效于 \x0c 和 \cL。 |
| \n | 换行符匹配。等效于 \x0a 和 \cJ。 |
| \r | 匹配一个回车符。等效于 \x0d 和 \cM。 |
| \s | 匹配任何空白字符,包括空格、制表符、换页符等。与 [ \f\n\r\t\v] 等效。 |
| \S | 匹配任何非空白字符。与 [^ \f\n\r\t\v] 等效。 |
| \t | 制表符匹配。与 \x09 和 \cI 等效。 |
| \v | 垂直制表符匹配。与 \x0b 和 \cK 等效。 |
| \w | 匹配任何字类字符,包括下划线。与"[A-Za-z0-9_]"等效。 |
| \W | 与任何非单词字符匹配。与"[^A-Za-z0-9_]"等效。 |
| \xn | 匹配 n,此处的 n 是一个十六进制转义码。十六进制转义码必须正好是两位数长。例如,"\x41"匹配"A"。"\x041"与"\x04"&"1"等效。允许在正则表达式中使用 ASCII 代码。 |
| num | 匹配 *num*,此处的 num 是一个正整数。到捕获匹配的反向引用。例如,"(.)\1"匹配两个连续的相同字符。 |
| n | 标识一个八进制转义码或反向引用。如果 n 前面至少有 n 个捕获子表达式,那么 n 是反向引用。否则,如果 n 是八进制数 (0-7),那么 n 是八进制转义码。 |
| nm | 标识一个八进制转义码或反向引用。如果 nm 前面至少有 nm 个捕获子表达式,那么 nm 是反向引用。如果 nm 前面至少有 n 个捕获,则 n 是反向引用,后面跟有字符 m。如果两种前面的情况都不存在,则 nm 匹配八进制值 *nm*,其中 n 和 m 是八进制数字 (0-7)。 |
| \nml | 当 n 是八进制数 (0-3),m 和 l 是八进制数 (0-7) 时,匹配八进制转义码 nml。 |
| \un | 匹配 n,其中 n 是以四位十六进制数表示的 Unicode 字符。例如,\u00A9 匹配版权符号 (©)。 |
39. Boolean转换及判断
在 JS 中,只有 0,-0,NaN,"",null,undefined 这六个值转布尔值时,结果为 false
[] == false // 没进行类型转换为false
[] == 0
Boolean([]) === true // 进行类型转换为true
![] === false // 进行了类型转换
NaN === NaN // false
Object.is(NaN, NaN) // true
+0 === -0 // true
Object.is(+0, -0) // false
null || undefined // undefined
undefined || null // null
null && undefined // null
undefined && null // undefined
return相关
构造函数内部的return如果return的是一个对象,则通过new调用会返回该对象(将替代通过new创建出来的对象);
构造函数内部没写return或return 常量则默认会返回一个通过new创建出来的对象。
try..catch语句相关的return,在有finally的情况下,无论try语句中有无return(或者是有break语句),都会执行finally语句的内容。
40. 其他js
var a = 1;
function test() {
  	// 这里的a访问的是if语句中的a,无法先使用再赋值,所以a => undefined
    console.log(a);
    if(true) {
        var a = 2;
    }
}
test();- 严格模式下,普通函数和立即执行函数的this指向undefined,定时器函数的this指向window
数组遍历
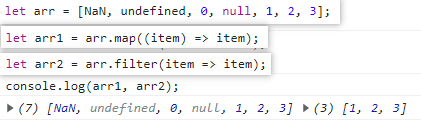
filter是过滤出符合条件的元素,将符合的元素放入一个新数组内返回(条件筛选返回)。
map是遍历数组,且对每个元素进行操作,将需要返回的元素放入数组内返回(直接处理返回,return啥数组里就是啥)。
find是遍历数组,返回符合条件的单个元素。
forEach是遍历数组,仅遍历数组。
some是检测数组是否有满足条件的元素,如有则返回true,没有则返回false。
every是检测数组是否所有元素都满足条件,都满足条件则返回true,有一个不满足条件则返回false。
reduce是遍历(迭代遍历),可以给reduce传入一个pre值,作为相应的初始值,返回一个新数组。
const arr = [1, 2, 4, 8, 11, 4, 8, 45];

let result = arr.reduce((pre, cur, inex, arr) => {
  return pre += cur;
}, 0)
console.log(result); // 83
切割字符串、数组
str.substring(start, end); // 不改变原字符
str.substr(start, length); // 不改变原字符
str.slice(start, end); // 不改变原字符

arr.slice(start, end); // 不会改变原数组
str.splice(start, length, replaceValue); // 会改变原数组
41.虚拟DOM diff算法
- diff算法就是两棵虚拟DOM树上节点的比较
- 前遍历,后便利,新增未匹配到的新节点,移除未匹配到的旧节点
- vue 和 react 在虚拟dom的diff上,做了哪些改进使得速度很快?
- vue3里使用了界面渲染时,不参与更新的节点会通过标记复用,减少不必要的渲染
- key的主要作用就是便于新旧节点的匹配与复用,通过key判断节点的新旧
42.vue双向绑定的原理
vue数据双向绑定是通过数据劫持结合发布者-订阅者模式的方式来实现的
将视图更新的方法放到数据劫持(Obejct.defineProperty里的set,new Proxy里的set)里进行就实现了双向数据绑定
Observer劫持数据,watcher负责订阅数据变化,以及更新视图,complier编译解析DOM节点
43.keep-alive
动态组件的缓存使用
<template>
  <div class="app">
    <div class="tabs">
      <template v-for="(item, index) in tabs" :key="item">
        <button :style="{ color: activeIndex === index ? 'red' : 'black' }" @click="btnClick(index)">{{ item }}</button>
      </template>
    </div>
    <!-- 视图组件展示第一种方式 -->
    <!-- <home v-if="activeIndex === 0"></home>
    <about v-else-if="activeIndex === 1"></about>
    <category v-else-if="activeIndex === 2"></category> -->
    <!-- 第二种方式:直接使用<components :is='name'></components> -->
    <!-- keep-alive会根据组件include创建时的name来判断组件切换时是否需要对组件进行缓存 -->
    <keep-alive include="home,about">
      <component :is="tabs[activeIndex]"></component>
    </keep-alive>
  </div>
</template>

<script>
import Home from './views/Home.vue'
import About from './views/About.vue'
import Category from './views/Category.vue'
export default {
  components: {
    Home,
    About,
    Category
  },
  data() {
    return {
      tabs: ['home', 'about', 'category'],
      activeIndex: 0
    }
  },
  methods: {
    btnClick(index) {
      this.activeIndex = index
    }
  }
}
</script>
44.vue 是怎么解析template的? template会变成什么?
template中的标签会通过正则等方式将其转换为AST语法树(对象,对象内根据template结构嵌套了对象或数组),然后经过一步优化,将其中的静态节点打上标签,最后将AST转换为render函数
45.实现一个批量请求函数,并能限制并发量(参考)
function multiRequest(urls, maxNum) {
  let results = new Array(urls.length).fill(null); // 创建数组,用于存放请求结果
  let currentIndex = 0; // 当前请求的索引
  let activeCount = 0; // 当前正在进行的请求个数
  function handleRequest(url, index) {
    activeCount++; // 当前正在进行的请求个数加1
    fetch(url).then(response => response.json()).then(data => {
      results[index] = data; // 存储请求结果
      activeCount--; // 当前正在进行的请求个数减1
      if (currentIndex < urls.length) {
        handleRequest(urls[currentIndex], currentIndex); // 继续进行下一个请求
        currentIndex++;
      }
      if (activeCount === 0) {
        console.log(results); // 所有请求完成后,按照 urls 里面的顺序依次打出结果
      }
    }).catch(error => console.error(error));
  }
  while (currentIndex < urls.length && currentIndex < maxNum) {
    handleRequest(urls[currentIndex], currentIndex);
    currentIndex++;
  }
}